Cómo los modelos de IA avanzada están ampliando las capacidades del procesamiento inteligente de documentos
Publicado: 25 de septiembre de 2026
La automatización documental solía funcionar solo cuando los documentos se comportaban. Las plantillas esperaban campos en posiciones fijas, mientras que las reglas asumían que facturas, contratos y formularios de siniestros mantendrían diseños familiares. Un rediseño menor podía devolver un flujo de trabajo por lo demás fiable a la revisión manual.
Los modelos de IA avanzada han cambiado el lado de la entrada de esa ecuación. En lugar de emparejar cada página con un patrón predefinido, un modelo de lenguaje grande (LLM) puede interpretar el lenguaje, el diseño y el contexto visual juntos. Estos modelos de frontera acercan el procesamiento documental a la lectura más que al emparejamiento de plantillas.
Ese cambio crea posibilidades que los sistemas más antiguos no podían respaldar, pero también introduce modos de fallo menos predecibles. La pregunta importante ya no es si los modelos pueden procesar documentos desconocidos. En cambio, es qué trabajo específico pueden realizar de forma fiable y dónde su aparente comprensión empieza a fallar.
La IA avanzada puede comprender documentos más allá de las plantillas fijas, pero el valor empresarial proviene de convertir esa comprensión en procesos fiables. docAlpha combina captura documental impulsada por IA, clasificación, extracción, validación, reglas inteligentes y automatización de flujos de trabajo.
Procese más tipos de documentos con menos intervención manual manteniendo a las personas involucradas donde el criterio importa.
Una factura ya no necesita el nombre del proveedor en la esquina superior izquierda ni el total en un cuadro predefinido. Con capacidades multimodales, un modelo puede identificar el proveedor, el importe adeudado y los términos de pago a partir de un diseño desconocido al interpretar etiquetas, texto circundante y estructura de la página.
Los modelos de razonamiento también aceptan instrucciones que van más allá de los campos mapeados. En un contrato, el pipeline puede señalar lenguaje que acorta un periodo de aviso, conectar ese lenguaje con una cláusula de terminación y devolver el pasaje relevante en lugar de limitarse a extraer cada fecha.
La clasificación cambia de la misma forma. Un formulario de siniestro puede enrutarse según el tipo de pérdida descrito en su contenido, mientras que un albarán de embalaje puede emparejarse con un flujo de recepción incluso cuando su nombre de archivo es un identificador de escaneo aleatorio. Comprender las diferencias entre IA y aprendizaje automático ayuda a explicar este cambio: el sistema está interpretando una nueva entrada en lugar de emparejarla con un diseño aprendido.
Para un flujo de facturas, el equilibrio es flexibilidad frente a control predecible. Un sistema basado en reglas falla cuando una coordenada requerida está vacía, haciendo visible la causa. Un modelo generativo podría, en cambio, inferir un total plausible a partir de partidas cercanas. Eso convierte la exactitud factual en un requisito de prueba para cada campo, tipo de documento y ruta de excepción.
Lectura recomendada: Aprenda cómo la IA y el aprendizaje automático difieren en el procesamiento documental
Ningún modelo lidera cada carga de trabajo documental. Los equipos que comparan GPT-5.4, Claude Opus 4.6 y Gemini 3.1 Pro sobre los mismos archivos o bien se conectan directamente a la API de cada proveedor, enrutan solicitudes a través de un endpoint multimodelo como ZenMux, o autoalojan modelos de pesos abiertos detrás de su propio firewall; la ruta correcta sigue a los documentos y a las restricciones de despliegue.
GPT-5.4 de OpenAI y Claude Opus 4.6 de Anthropic son opciones prácticas para el análisis a nivel de cláusula en contratos largos. Estos modelos pueden seguir definiciones, excepciones y referencias cruzadas a lo largo de decenas de páginas, lo que importa cuando una limitación en una sección cambia el significado de una obligación en otra.
Encajan en trabajos como comparar el lenguaje de indemnización con un playbook o rastrear condiciones de renovación a lo largo de un acuerdo. Sin embargo, sus mayores demandas de procesamiento los hacen menos económicos para leer una fecha de cada factura rutinaria.
Google Gemini 3.1 Pro encaja en la recepción donde los documentos combinan fotografías, escritura a mano, tablas, sellos y texto tipografiado sin una capa de texto limpia. Sus capacidades multimodales permiten que un solo modelo interprete la estructura visible de la página y el lenguaje en lugar de depender por completo de la salida OCR.
Eso lo hace relevante para formularios de siniestros fotografiados, informes de inspección anotados y solicitudes escaneadas. Sin embargo, las técnicas de deep learning no eliminan los problemas causados por una mala calidad de origen. La escritura a mano débil, los bordes recortados y las marcas superpuestas siguen requiriendo comprobaciones de calidad de imagen y revisión dirigida.
Los modelos Meta Llama y Mistral AI intercambian parte de la precisión de frontera por control de despliegue, rendimiento predecible y mejor latencia y eficiencia de costes a alto volumen. El autoalojamiento también mantiene el contenido documental dentro de la infraestructura controlada por la organización.
Los modelos de lenguaje pequeños manejan trabajos más estrechos, como encontrar fechas, totales y tipos de documento, sin incurrir en costes de modelos de frontera por cada página. La mayoría de los pipelines de producción, por tanto, usan niveles: un modelo más pequeño clasifica y enruta archivos rutinarios, mientras que un modelo más capaz recibe solo contratos, excepciones o campos ambiguos que requieren criterio.
Revisar manualmente cada campo extraído elimina gran parte del valor de la automatización inteligente. InvoiceAction automatiza la captura, validación y emparejamiento rutinarios de facturas mientras dirige las excepciones a los empleados para su revisión.
Aumente la productividad de CxP manteniendo la atención humana centrada donde los errores o discrepancias tienen mayores consecuencias.
Una gran ventana de contexto o límite de tokens determina cuánto contenido puede recibir un modelo, no con qué fiabilidad recuerda cada detalle. Durante el análisis de documentos largos, un modelo puede identificar las definiciones iniciales y los términos finales de firma de un contrato de 300 páginas y, aun así, pasar por alto una cualificación enterrada cerca del medio.
Los techos de salida crean otra restricción. Leer un expediente de siniestro largo puede caber dentro de la franquicia de entrada, pero producir un registro estructurado para cada página puede superar la longitud de respuesta permitida. El pipeline necesita entonces extracción por etapas, lotes específicos de esquema o un almacén externo para resultados intermedios.
El fragmentado resuelve problemas de capacidad mientras crea problemas de contexto. Si un arrendamiento se divide por sección, un fragmento puede contener una obligación, mientras que otro contiene la definición que la delimita. Los modelos de razonamiento necesitan pasajes solapados, referencias cruzadas recuperadas o una segunda pasada de síntesis para preservar esa relación.
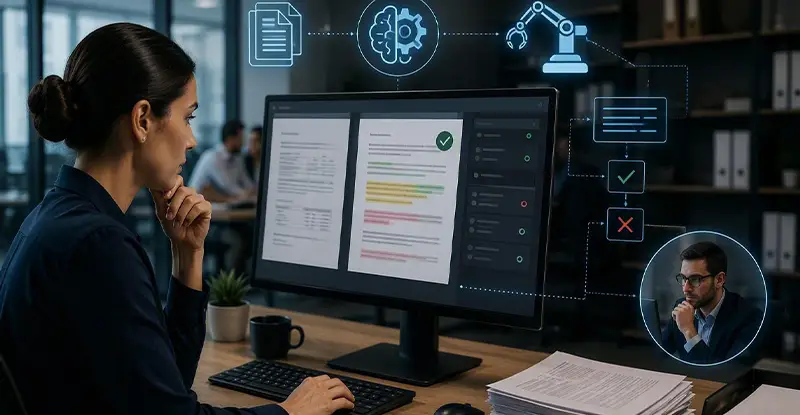
La IA agéntica amplía el flujo de trabajo más allá de la extracción. Una configuración agéntica puede leer una factura, recuperar su orden de compra, comparar cantidades y precios y enviar solo las discrepancias a una cola humana en lugar de detenerse en un payload JSON.
Cada paso adicional, sin embargo, crea otro punto de fallo. Un ID de proveedor erróneo puede recuperar la orden de compra equivocada, lo que luego produce una excepción convincente pero irrelevante. Las comprobaciones deben situarse, por tanto, en cada transferencia, cubriendo el emparejamiento de identidad, la recuperación, la comparación y el enrutamiento final, en lugar de tratar la cadena como una sola decisión de confianza.
Lectura recomendada: Descubra cómo los algoritmos de IA transforman la automatización inteligente de procesos
Un pipeline documental debe superar dos puertas separadas. La exactitud determina si los datos extraídos pueden respaldar un pago, un siniestro o una decisión contractual. La gobernanza y el cumplimiento determinan si el modelo puede recibir ese documento, dónde ocurre el procesamiento y qué registros conserva el flujo de trabajo.
La alucinación en el procesamiento documental a menudo parece lo bastante específica como para escapar a una revisión casual. Un modelo podría rellenar una fecha de vigencia ausente a partir de lenguaje cercano o calcular un total a partir de partidas aunque la página no indique ninguno. Una tasa baja de alucinación a nivel de documento puede ocultar errores inaceptables en importes de pago.
Las puntuaciones de confianza generativas no están calibradas como las de emparejamiento de plantillas. Los umbrales necesitan reconstruirse frente a una muestra etiquetada de las propias facturas, contratos o siniestros de la organización. Los resultados de SWE-bench y GPQA dicen poco sobre la exactitud factual a nivel de campo porque prueban capacidades distintas.
La revisión con humanos en el bucle debe dirigirse a campos de alto valor, inferencias no respaldadas y salidas de baja confianza. Revisar cada dirección de proveedor y total de factura extraídos elimina la mayor parte del beneficio económico de la automatización.
La captura tradicional tiene dificultades cuando cambian los diseños, formatos y estructuras documentales. docAlpha usa procesamiento inteligente de documentos para comprender y extraer información de documentos empresariales variados, validar los resultados y mover datos precisos a los flujos de trabajo posteriores.
Reduzca la configuración y el procesamiento manual mientras construye una automatización documental más flexible.
Los documentos regulados pueden restringir la opción de despliegue antes de que entre en juego la calidad del modelo. Los requisitos de privacidad de datos y soberanía de datos pueden apuntar hacia modelos de pesos abiertos autoalojados, procesamiento regional o contratos que prohíban a los proveedores entrenar con el contenido enviado.
Las revisiones de privacidad deben cubrir más que el documento de origen. Los prompts, los campos extraídos, los registros, las respuestas en caché y las muestras de evaluación representan movimiento o retención de datos. El Perfil de IA generativa del NIST proporciona un marco para incorporar la fiabilidad y los controles de riesgo a lo largo del diseño, la evaluación y el uso del sistema.
Los controles de gobernanza deben seguir el flujo de trabajo completo. Los permisos de acceso, los periodos de retención, las versiones de modelo, los cambios de prompt y las decisiones de los revisores necesitan trazabilidad, en particular cuando la salida respalda una decisión regulada o financieramente significativa. Los modelos de frontera no eliminan esas obligaciones; añaden nuevas capas de procesamiento que la gobernanza debe cubrir.
La pregunta sobre la capacidad está en gran medida resuelta. Los modelos de frontera pueden procesar diseños desconocidos, interpretar el lenguaje documental, conectar información entre páginas y pasar los hallazgos extraídos a flujos de trabajo posteriores. La automatización basada en plantillas no podía manejar ese rango sin una configuración extensa.
Las preguntas sin resolver conciernen al ajuste y la verificación. El razonamiento contractual, la recepción manuscrita, la extracción repetitiva de facturas y los registros regulados no requieren el mismo modelo ni el mismo patrón de despliegue. La complejidad de la carga de trabajo, el estado del documento, la latencia, el coste y la exposición regulatoria importan más que la posición en un ranking. El pipeline más sólido es, por tanto, el que asigna cada documento a un modelo adecuado y mantiene el criterio humano exactamente donde un error no detectado tendría consecuencias reales.
Lectura recomendada: Aprenda cómo la supervisión humana refuerza el procesamiento documental automatizado
 Machine Learning frente a IA: dos tecnologías revolucionarias
 Algoritmos de IA en automatización inteligente de procesos (guía 2026) | Artsyl
 Procesamiento automático de facturas en 2025–2026: automatización con IA y supervisión humana
 IA con humanos en el bucle para la automatización documental inteligente
 Todo sobre el procesamiento inteligente de documentos
 Captura cognitiva: cómo la IA va más allá del OCR tradicional

