Por qué la automatización documental inteligente sigue necesitando humanos en el bucle
Publicado: 4 de septiembre de 2026
Todo equipo financiero que ha implantado la automatización de facturas conoce el patrón. El primer mes parece brillante: el 80% de las facturas fluye sin intervención, la entrada de datos disminuye y las cuentas por pagar cierran más rápido que nunca. Luego un nuevo proveedor envía un PDF escaneado con un número de orden de compra manuscrito, un cliente sanitario presenta un formulario de reclamación con un diseño que el modelo nunca ha visto, y la cola de excepciones empieza a crecer.
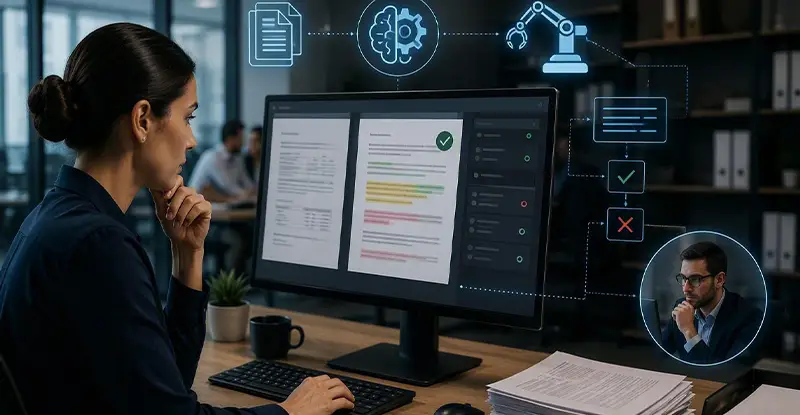
Esto no es un fallo de la tecnología. Así se comporta el aprendizaje automático en el mundo real, y explica por qué los sistemas de procesamiento documental más eficaces no son totalmente autónomos. Están diseñados en torno a un bucle en el que las personas corrigen, etiquetan y enseñan al modelo, y el modelo mejora al tratar el siguiente documento. Entender cómo funciona ese bucle es la diferencia entre un proyecto de automatización que se estanca en “casi funciona” y uno que sigue mejorando.
La IA puede procesar grandes volúmenes con rapidez, pero las excepciones siguen requiriendo decisiones informadas. docAlpha combina el procesamiento documental inteligente con flujos de verificación que ayudan a los equipos a validar datos inciertos antes de que lleguen a los sistemas posteriores.
Reduzca errores costosos mientras crea un camino más fiable desde la captura documental hasta la automatización de procesos de negocio.
La captura documental moderna combina varias capas de tecnología. El reconocimiento óptico de caracteres convierte píxeles en texto. El aprendizaje automático clasifica el documento (¿es una factura, una orden de compra, un informe de laboratorio?) y extrae los campos que importan: nombre del proveedor, total, fecha de vencimiento, ID del paciente, líneas de detalle. La automatización robótica de procesos (RPA) toma esos valores estructurados y los envía a un ERP, un sistema contable o una historia clínica electrónica. Las herramientas de inteligencia de negocio se sitúan encima y convierten los datos capturados en paneles y análisis.
La capa de extracción es donde reside la mayor parte de la inteligencia, y también donde ocurren la mayoría de los errores. Un modelo entrenado con diez mil facturas limpias y mecanografiadas de grandes proveedores funcionará bien con la factura número once mil de un gran proveedor. Rendirá mucho peor con un recibo fotografiado, una orden de compra multilingüe o un formulario en el que un campo se ha desplazado tres centímetros a la izquierda. En cuentas por pagar, eso puede significar una factura mal pagada. En medicina, puede significar una dosis leída incorrectamente en una carta de remisión.
Lectura recomendada: Cómo funciona el manejo de excepciones de facturas en AP automatizado
Esta es la parte que se pasa por alto en la mayoría de las demos de proveedores. Todo documento que el modelo no puede procesar con confianza pasa a una persona. Esa persona lee el documento, corrige los valores extraídos y lo aprueba. En un sistema bien diseñado, esa corrección no se descarta. Se reintroduce en el modelo como un ejemplo etiquetado.
Esto es aprendizaje automático con humanos en el bucle, y es el mecanismo por el que los sistemas de procesamiento documental mejoran tras el despliegue. El modelo no aprende de las facturas que manejó correctamente; aprende de las que falló y un humano corrigió. Con el tiempo, la tasa de excepciones baja, no porque se actualizara el software, sino porque la organización generó sus propios datos de entrenamiento mediante el trabajo operativo cotidiano.
De esto se derivan algunas implicaciones prácticas:
Las correcciones deben capturarse de forma estructurada. Si un administrativo corrige un total erróneo en el ERP después del hecho, el modelo nunca lo ve. La corrección tiene que ocurrir en la interfaz de captura, donde el campo, la predicción original y el valor corregido se registran juntos.
Los umbrales de confianza son una decisión de negocio, no técnica. Enviar a revisión todos los documentos por debajo del 95% de confianza genera muchos datos etiquetados, pero ralentiza el procesamiento. Fijar el umbral en el 70% acelera el proceso, pero deja pasar más errores. Los equipos de cuentas por cobrar con objetivos estrictos de flujo de caja y los administradores sanitarios que gestionan historiales de pacientes llegarán, con razón, a puntos distintos.
Los revisores realizan un trabajo cualificado. Leer una factura densa de un proveedor, detectar que una línea está duplicada, decidir si un carácter ambiguo es un “1” o una “l” – esto es juicio, y debe dotarse de recursos y medirse como tal.
Las facturas con diseños inusuales, valores dudosos o excepciones de matching siguen necesitando una revisión informada. InvoiceAction automatiza la captura y el procesamiento de facturas mientras mantiene a las personas involucradas allí donde la validación y el juicio aportan valor.
Aumente la productividad de AP sin sacrificar la precisión financiera de la que dependen su ERP y sus procesos de pago.
El bucle de retroalimentación anterior resuelve el problema continuo. No resuelve el problema de arranque en frío: un modelo necesita miles de documentos etiquetados con precisión antes de poder desplegarse, y muchas organizaciones simplemente no tienen ese historial en una forma usable.
Por eso una parte grande y creciente del trabajo de aprendizaje automático se hace ahora mediante etiquetado distribuido. En lugar de contratar un equipo interno de anotación, las empresas dividen el trabajo en microtareas – dibujar un recuadro alrededor del total de la factura, transcribir este campo, confirmar que este formulario es una reclamación y no una remisión – y las distribuyen a un amplio grupo de trabajadores remotos. Plataformas como JumpTask conectan a personas que quieren ganar con tareas online cortas con empresas que necesitan juicio humano a escala, también para entrenar modelos de IA. El mismo enfoque crowdsourcing se usa para todo, desde etiquetar imágenes médicas hasta verificar la salida de grandes modelos de lenguaje.
Para un proyecto de automatización documental, esto tiene dos efectos. Comprime el tiempo hasta un modelo operativo de meses a semanas, y permite al equipo construir un conjunto de entrenamiento que refleje la variedad desordenada de documentos reales, no el subconjunto ordenado que casualmente estaba en un archivo. El control de calidad sigue importando: los buenos flujos de etiquetado envían cada tarea a varios anotadores y usan el acuerdo entre ellos como señal de fiabilidad, lo cual es en sí mismo una forma de diseño con humanos en el bucle.
Lectura recomendada: Descubra cómo los datos de entrenamiento mejoran la precisión del aprendizaje automático
El instinto al comprar herramientas de automatización es preguntar “¿qué porcentaje puede gestionar esto sin un humano?” Es una pregunta razonable, pero trata el paso humano como un coste a minimizar en lugar de un aporte a diseñar. Los equipos que más sacan de la automatización inteligente suelen plantear otro conjunto de preguntas:
Responder bien a estas preguntas produce un sistema que gestiona más cada mes, ya sean facturas en un back office de FinTech, órdenes de compra en el flujo de procesamiento de pedidos de un distribuidor o formularios de admisión en un hospital. Responderlas mal produce un modelo que rinde bien el primer día y se degrada en silencio a medida que el mundo cambia a su alrededor.
A medida que aumentan los volúmenes de pedidos, revisar manualmente cada orden de compra se vuelve caro y difícil de escalar. OrderAction automatiza la captura documental y la extracción de datos de pedidos mientras apoya la verificación humana cuando la confianza o las reglas de negocio lo requieren.
Aumente la capacidad de procesamiento, reduzca errores y acelere el camino desde la OC del cliente hasta el pedido de venta en el ERP.
Las plataformas de automatización en la nube facilitan cada año el lado técnico: modelos preentrenados para tipos de documentos comunes, conectores RPA integrados, analítica que saca a la luz los cuellos de botella de forma automática. Lo que no ha cambiado es que los documentos los producen personas, para personas, en formatos que cambian constantemente. El aprendizaje automático es notablemente bueno con los patrones que ha visto y notablemente malo con los que no ha visto.
Las organizaciones que obtienen valor duradero de la automatización documental han dejado de tratar el elemento humano como una fase de transición a automatizar por completo. Lo han integrado: como revisores en la cola de excepciones, como anotadores que construyen el conjunto de entrenamiento y como la fuente continua de los ejemplos etiquetados que hacen que el modelo merezca la pena ejecutarse desde el principio.
Lectura recomendada: Por qué el procesamiento automatizado de facturas sigue necesitando supervisión humana
 Cómo funciona el manejo de excepciones de facturas en sistemas AP automatizados
 La importancia de la precisión en el aprendizaje automático: una guía completa
 Procesamiento automatizado de facturas en 2025–2026: automatización con IA y supervisión humana
 Por qué la automatización financiera necesita supervisión humana hoy
 Diseñar flujos de IA que apoyen la productividad humana
 Todo sobre el procesamiento documental inteligente

