Por qué cada tabla PDF pegada necesita Texto en columnas en Excel
Publicado: 24 de septiembre de 2026
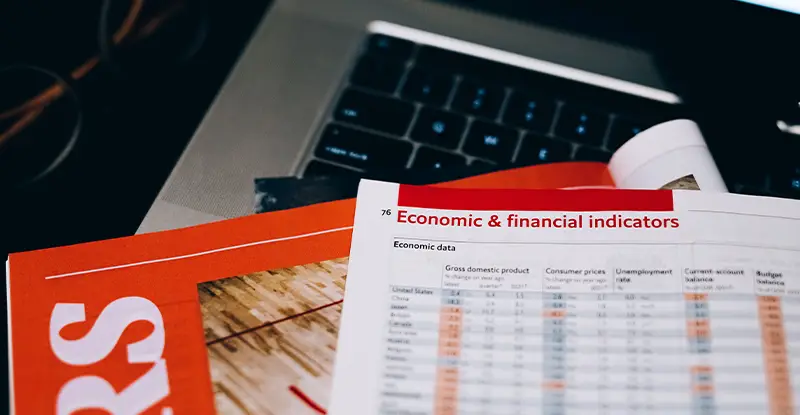
Copia una tabla de un PDF, la pega en Excel y cada fila termina en la columna A como una sola cadena larga. Los números están todos ahí. Las columnas han desaparecido. Parece un error de pegado, pero la causa real está dentro del propio PDF, no en nada que usted haya hecho mal, y volver a escribir toda la hoja a mano no debería ser la única salida.
Un PDF no tiene el concepto de filas y celdas como Excel. En el fondo, solo almacena instrucciones para dibujar caracteres en posiciones específicas de una página. Las columnas ordenadas de una tabla son, en realidad, solo texto colocado con un espaciado horizontal consistente, nada más. No hay marcas de límite donde termina una columna y empieza la siguiente, y ningún identificador de fila vincula un número con la etiqueta que tiene al lado.
Al copiar ese texto, la alineación visual no viaja con él. Excel recibe una cadena de caracteres y saltos de línea, sin ningún delimitador que le indique dónde dividir una columna. Todo de una fila termina en una sola celda, en el orden en que el PDF haya decidido almacenarlo. Un pequeño número de PDF incluye etiquetas de estructura ocultas pensadas para lectores de pantalla, pero la mayoría de los documentos empresariales e informes escaneados omiten ese paso por completo, dejando a Excel sin nada a lo que agarrarse.
Las filas, columnas y relaciones que parecen obvias para una persona pueden desaparecer cuando el contenido de un PDF se copia a otra aplicación. docAlpha usa procesamiento inteligente de documentos para comprender y extraer información de documentos y tablas complejos.
Reduzca la limpieza manual y mueva datos precisos y estructurados directamente a los procesos empresariales posteriores.
El daño suele aparecer de formas concretas. Los encabezados de columna pueden mezclarse con la primera fila de datos tabulares en lugar de quedar encima. Los números pueden arrastrar caracteres de formato extraños que hacen que Excel trate un valor real como texto plano en lugar de algo que pueda sumar. Las filas incluso pueden llegar desordenadas, ya que un PDF a menudo almacena cada columna como un bloque de texto separado en lugar de una fila a la vez.
Nada de esto es aleatorio. Se deriva directamente del hábito del PDF de rastrear dónde están los caracteres, no qué significan. Cualquier método de extracción de datos que se base solo en el texto pegado hereda el mismo punto ciego, por muy cuidadoso que sea el pegado.
Un punto usado como separador de miles en el archivo de origen también es un tropiezo habitual, ya que Excel puede leerlo como un decimal y cambiar en silencio el valor de cada número que lo lleve.
Lectura recomendada: Aprenda cómo el OCR extrae datos utilizables de documentos empresariales
Recurrir a Texto en columnas en Excel suele ser lo primero que la gente intenta. En Datos, el asistente toma una columna pegada y la divide usando un delimitador que usted elige, como una coma o un tabulador, o un ancho fijo basado en la posición de los caracteres.
Funciona bien con datos simples y consistentes. Las tablas pegadas reales rara vez se mantienen tan cooperativas:
- Los anchos de columna cambian ligeramente de una fila a otra en el PDF de origen
- Un solo valor con un espacio interno puede dividirse por error en dos columnas
- Las celdas combinadas o envueltas en la tabla original desajustan cada fila posterior
Una sola fila desalineada suele bastar para desincronizar el resto de la hoja, y corregirlo a mano anula el propósito de pegar en primer lugar.
Se mencionan mucho dos soluciones alternativas. Pegar primero en Word a veces conserva más estructura, aunque después aún hay que arreglar el desorden a mano en Excel. Power Query de Microsoft 365 puede extraer una tabla directamente de un PDF, pero no puede leer una página escaneada y tiende a importar todo el archivo en lugar de solo la tabla que necesita.
Un PDF preserva cómo se ve la información en una página, no necesariamente las filas, columnas y relaciones que necesitan sus sistemas posteriores. docAlpha captura el contenido documental y lo transforma en datos empresariales estructurados y validados.
Vaya más allá de los documentos visuales y prepare la información extraída para la automatización.
El software creado específicamente para manejar la conversión de PDF a Excel mira la tabla como lo haría una persona, leyendo los límites de columna y los saltos de fila directamente de la página en lugar de trabajar a partir de un solo bloque plano de texto. Esa es la brecha entre el software creado para extraer tablas de archivos PDF y un simple copiar-pegar, que nunca tuvo ese contexto. El mismo enfoque funciona también con un informe escaneado, algo que el copiar-pegar o Texto en columnas no pueden recuperar por sí solos.
Para una tabla que necesita en orden de trabajo sin ninguna división manual, convierta PDF a Excel gratis con OnlyDoc, que reconstruye las columnas originales directamente en lugar de volcar todo en una sola. Los números también llegan como valores reales, de modo que se conectan directamente a una nueva fórmula en lugar de quedarse como texto inutilizable. Actualmente maneja un archivo a la vez, lo que cubre la mayoría de los casos cotidianos sin ninguna configuración adicional.
Lectura recomendada: Cómo usar software OCR para PDF y otros formatos de archivo
Un PDF nunca se diseñó para contener una tabla real, así que las columnas nunca iban a sobrevivir a un simple copiar y pegar. Reconstruirlas a mano con Texto en columnas funciona en casos simples, y convertir el archivo directamente omite ese paso por completo. En cualquier caso, la solución empieza por saber por qué desapareció la columna en primer lugar.
 Conversión de PDF OCR
 Extracción de datos con OCR: facturas, formularios y recibos
 Descubra todo lo que necesita saber sobre la extracción de datos
 Los mejores formatos de conversión de PDF para mayor precisión y calidad
 Conversión de imágenes a texto con OCR: qué es
 Captura cognitiva: cómo la IA va más allá del OCR tradicional

