Ingeniería de datos: la base del procesamiento inteligente de documentos
Publicado: 23 de enero de 2026
Una empresa de logística procesaba 50,000 documentos de envío al mes mediante captura manual de datos. El personal dedicaba 200 horas a extraer direcciones, pesos y números de seguimiento de formularios escaneados. La empresa implementó un flujo de trabajo de procesamiento inteligente de documentos (IDP) que capturaba automáticamente los datos de facturas y conocimientos de embarque. Los ingenieros de datos crearon reglas de validación para comprobar los formatos de las direcciones y señalar pesos sospechosos antes de que la información llegara al sistema del almacén. El tiempo de procesamiento se redujo a 20 horas al mes y los errores de entrega disminuyeron un 35%.
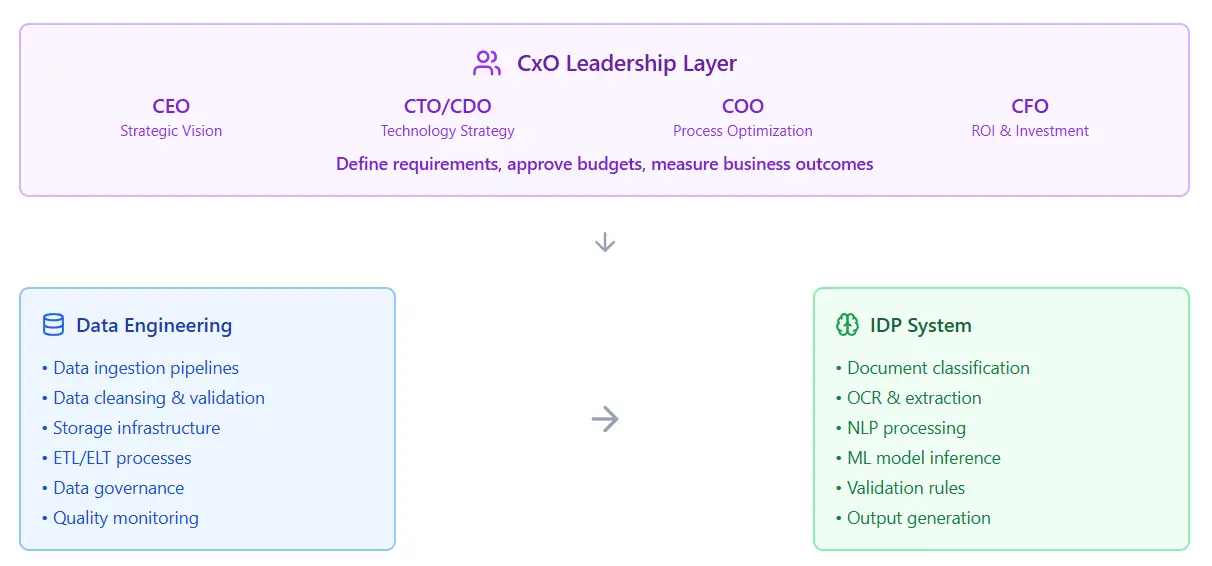
Relación entre ingeniería de datos, IDP y CxO
Las organizaciones implementan plataformas de automatización inteligente para crear la infraestructura (conectores, reglas de validación, flujos de trabajo, paneles de supervisión y gestores de excepciones) que vincula sistemas dispares. Estas plataformas funcionan como la columna vertebral operativa del movimiento de datos y la orquestación de procesos. La ingeniería de datos refuerza esta base al aplicar prácticas rigurosas a la calidad de los datos, la lógica de transformación y la fiabilidad de los pipelines. Su valor se hace más evidente en entornos ERP complejos, donde los sistemas heredados y las integraciones personalizadas exigen una gestión de datos minuciosa. Las iniciativas de analítica también se benefician: los pipelines de datos limpios y bien estructurados permiten análisis más rápidos y reducen el costo de corregir errores en etapas posteriores.
docAlpha combina el procesamiento inteligente de documentos con conectores, reglas de validación, supervisión y gestión de excepciones, de modo que los datos extraídos estén listos para producción, no solo sean legibles. Convierta la extracción con IA en una automatización fiable, de nivel ERP y a escala.
Las empresas procesan millones de documentos cada año, desde facturas y contratos hasta formularios médicos. El IDP promete automatizar este trabajo mediante IA que lee y extrae información sin intervención humana directa.
El IDP utiliza IA para extraer y organizar automáticamente la información de los documentos. La tecnología lee facturas, contratos, formularios y recibos sin intervención humana. Los sistemas IDP se dividen en tres tipos principales según la estructura de los documentos:
Las empresas eligen su tipo de IDP en función de la variedad de documentos y del volumen de procesamiento.
Lectura recomendada: Cómo los algoritmos de IA están transformando la automatización inteligente de procesos
El IDP automatiza la gestión de documentos en cuentas por pagar (AP), donde extrae las facturas de proveedores y las condiciones de pago.
Ponga en operación el IDP a escala empresarial
docAlpha convierte la extracción en flujos de trabajo controlados con validación, gestión de excepciones, pistas de auditoría y resultados listos para el ERP. Reduzca el riesgo de depender “solo de la IA” y haga que la automatización de documentos sea fiable en producción.
Reserve una demo ahora
Los sistemas IDP extraen datos y gestionan tareas de procesamiento por sí solos. Funcionan desde el primer momento y pueden enrutar facturas, analizar contratos y completar campos sin código personalizado. Los resultados mejoran cuando los ingenieros añaden reglas de validación: comprobaciones que detectan fechas en formatos mixtos o símbolos de moneda que alteran los sistemas contables. Los ingenieros también crean pipelines que trasladan los datos extraídos a bases de datos, ERP y plataformas de analítica, convirtiendo resultados aislados en flujos de trabajo conectados. La supervisión se vuelve más precisa cuando los equipos controlan los niveles de confianza de la extracción, vuelven a entrenar los modelos con nuevos tipos de documentos y configuran alertas automáticas para las excepciones que, de otro modo, se acumularían en silencio.
Una empresa de ingeniería de datos construye la infraestructura que hace avanzar los documentos por la ingesta, la limpieza, la extracción, la validación y la carga en los sistemas de producción. Es una solución estratégica para las corporaciones que buscan escalar. Cada etapa requiere lógica personalizada, gestión de errores y supervisión para convertir los archivos sin procesar en información empresarial fiable.
Captura documentos de múltiples fuentes (correo electrónico, escáneres, almacenamiento en la nube o API) y los dirige a un pipeline de procesamiento. El sistema valida los formatos de archivo, aplica reconocimiento óptico de caracteres a las imágenes y extrae metadatos antes de que comience la clasificación. Gestiona lotes y flujos en tiempo real con la misma eficacia. La gestión de errores integrada detecta archivos dañados, páginas faltantes o texto ilegible antes de que alteren los flujos de trabajo posteriores. El resultado son datos limpios y estructurados, listos para su análisis, almacenamiento o conexión con los sistemas empresariales actuales.
Lectura recomendada: Cómo modernizar el procesamiento de documentos con la automatización inteligente de procesos
El preprocesamiento de datos del IDP toma los documentos ingeridos sin procesar y los prepara para un análisis inteligente. El sistema elimina el ruido, como marcas de agua, sellos y encabezados irrelevantes que confunden a los algoritmos de extracción. Corrige las distorsiones de imagen (endereza escaneos torcidos, ajusta el brillo y enfoca los datos borrosos) para mejorar la precisión del OCR. La solución normaliza las variaciones de los documentos, convirtiendo distintos formatos y diseños en estructuras uniformes que los modelos posteriores pueden analizar de forma fiable. Identifica y señala documentos incompletos, envíos duplicados y páginas con problemas de calidad que requieren revisión humana. Los datos limpios y estandarizados salen del pipeline listos para la clasificación, la extracción y la aplicación de reglas de negocio.
Refuerce la ingesta y el preprocesamiento
docAlpha admite una recepción estructurada, un preprocesamiento preparado para OCR y estándares uniformes de captura de datos en múltiples fuentes de documentos. Aumente la precisión y el rendimiento sin crear cuellos de botella manuales.
Reserve una demo ahora
Esta etapa identifica y extrae información específica de los documentos: identificadores de facturación, fechas, partidas, direcciones y los campos personalizados que su empresa necesita. Los modelos de ML entrenados con sus tipos de documentos reconocen dónde se encuentran los datos, incluso cuando los diseños cambian entre proveedores o versiones. El sistema gestiona formularios estructurados, facturas semiestructuradas y contratos no estructurados con técnicas diferentes para cada caso. Los indicadores de fiabilidad señalan las extracciones dudosas para revisión humana, de modo que los errores se detectan antes de que entren en sus sistemas. Los datos extraídos fluyen hacia bases de datos, plataformas ERP o herramientas de analítica en el formato que usted especifique.
Las reglas de validación contrastan la información extraída con reglas de negocio, bases de datos y fuentes externas para detectar errores antes de que causen problemas. El sistema coteja los totales de las facturas con la suma de las partidas, verifica los números de proveedor con los datos maestros de su ERP y señala las fechas que quedan fuera de los rangos previstos. Aplica lógica personalizada específica de sus flujos de trabajo: conciliación de órdenes de compra, cálculos de impuestos o comprobaciones de cumplimiento normativo. Los datos que superan la validación pasan automáticamente a los sistemas de producción, mientras que las excepciones se dirigen a especialistas que pueden corregir los errores en segundos en lugar de días.
La carga de datos del IDP toma la información validada y la escribe en sus sistemas de destino: plataformas ERP, sistemas de gestión documental, almacenes de datos o aplicaciones personalizadas. El sistema asigna los campos extraídos a las columnas de base de datos, los endpoints de API o los formatos de archivo correctos que requiere cada destino. Gestiona los errores sin contratiempos: si un sistema de destino no está disponible o rechaza un registro, la solución pone los datos en cola y vuelve a intentarlo automáticamente. Las pistas de auditoría registran cada operación de carga con marcas de tiempo, ID de usuario e indicadores de éxito para los informes de cumplimiento. La gestión de transacciones mantiene juntos los registros relacionados, de modo que el encabezado de una factura nunca llega a su ERP sin sus partidas. El resultado son datos precisos en el lugar adecuado y en el momento oportuno, listos para que sus equipos actúen.
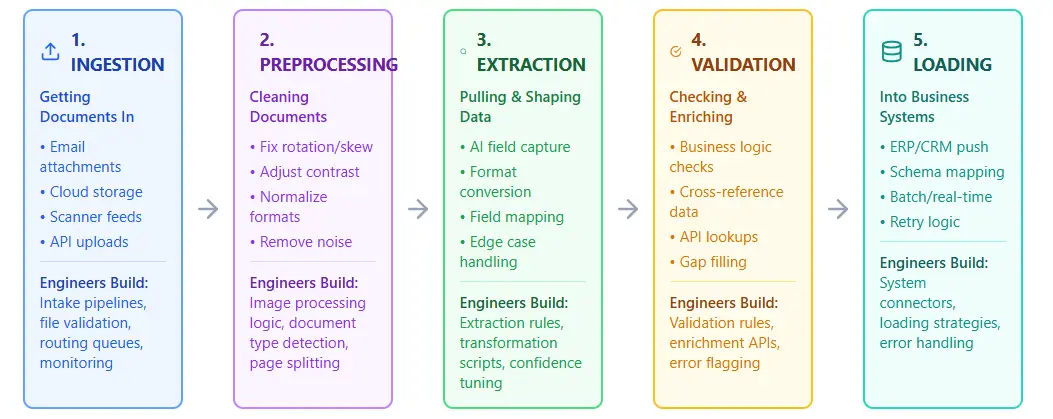
Etapas críticas en las que los ingenieros de datos hacen funcionar el IDP
ETL extrae los datos de los documentos, los transforma en formatos limpios y luego los carga en los sistemas de destino. La transformación se produce antes de la carga, por lo que solo los datos validados entran en el almacén de datos o el ERP. ELT invierte este orden: primero carga los datos extraídos sin procesar y después los transforma dentro del sistema de destino. Los flujos de trabajo de IDP suelen utilizar ETL para documentos estructurados en los que las reglas de validación son claras y uniformes. ELT se adapta a situaciones en las que los científicos de datos necesitan acceder al texto extraído sin procesar para el entrenamiento de machine learning o el análisis exploratorio.
Prepare los resultados de ETL/ELT para el negocio
docAlpha aplica reglas de negocio, validación de campos y enrutamiento de excepciones basado en la confianza antes de que los datos lleguen a los flujos de trabajo de ERP, finanzas o cumplimiento normativo. Evite reprocesos posteriores y proteja la exactitud financiera.
Reserve una demo ahora
Ingesta a escala: los pipelines modernos de ETL/ELT pueden ingerir automáticamente miles de PDF, contratos y facturas de forma simultánea.
Transformación automatizada: OCR + NLP extraen campos estructurados (por ejemplo, códigos de factura o cláusulas contractuales) sin manipulación física.
Carga rápida: los datos fluyen directamente a los sistemas ERP/CRM, lo que reduce los tiempos de respuesta de días a minutos.
Impacto: comprobaciones de cumplimiento más rápidas, conciliaciones financieras más ágiles y menos cuellos de botella operativos.
Estandarización: los procesos ETL normalizan los diversos formatos de documentos en esquemas uniformes.
Reglas de validación: las comprobaciones integradas verifican que los datos extraídos cumplan las normas regulatorias y contables.
Pistas de auditoría: los pipelines ELT conservan los metadatos y los registros de transformación para su defensa jurídica.
Impacto: los datos fiables y conformes aceleran las auditorías, los informes y la gestión del ciclo de vida de los contratos.
ELT en tiempo real: envía datos estructurados directamente a almacenes de datos en la nube o a sistemas ERP/CRM.
Vinculación entre sistemas: los datos financieros y legales pueden enriquecerse con datos maestros (clientes, proveedores, ID de casos).
Listos para la analítica: disponibilidad inmediata para paneles, detección de fraudes o puntuación de riesgos.
Impacto: las organizaciones obtienen información más rápidamente, lo que favorece una toma de decisiones con visión de futuro en las operaciones financieras y legales.
Lectura recomendada: Automatización inteligente: ¿qué es?
Los ingenieros de datos diseñan reglas de validación, crean sistemas de supervisión y establecen ciclos de retroalimentación que detectan los errores de extracción antes de que perjudiquen las operaciones del negocio. Implementan comprobaciones automatizadas en cada etapa del pipeline, desde la ingesta hasta la carga, y fijan umbrales de confianza que dirigen las extracciones dudosas a revisores humanos.
IDP que estandariza todos los formatos de factura
InvoiceAction automatiza el procesamiento de facturas extrayendo campos de forma fiable de archivos PDF, escaneos y correos electrónicos mediante reglas inteligentes. Aumente el procesamiento directo y minimice las excepciones.
Reserve una demo ahora
La tecnología OCR escanea las imágenes de los documentos y convierte el texto visible en caracteres legibles por máquina. El software identifica las formas de las letras, los límites de las palabras y los bloques de texto en toda la página. Los modelos de IA van más allá del reconocimiento básico de caracteres al comprender la estructura y el contexto del documento. Los algoritmos de machine learning detectan encabezados de factura, filas de tablas y bloques de firma sin plantillas predefinidas. El procesamiento del lenguaje natural extrae el significado de texto no estructurado e identifica nombres de proveedores en párrafos o fechas ocultas en cláusulas contractuales. Los modelos de visión artificial gestionan texto manuscrito, casillas de verificación y sellos estampados que el OCR tradicional pasa por alto. En conjunto, el OCR proporciona el texto sin procesar y la IA interpreta lo que ese contenido significa para los procesos de negocio.
La salida del OCR contiene errores de reconocimiento, como “O” en lugar de “0” o “l” en lugar de “1”, que alteran los campos numéricos. Los ingenieros escriben patrones regex y tablas de búsqueda para detectar las sustituciones erróneas más comunes y corregirlas automáticamente. Los espacios adicionales, los saltos de línea y los caracteres especiales se eliminan de los datos extraídos para ajustarse a los formatos de los campos de la base de datos. Los analizadores de fechas gestionan decenas de variantes de formato y convierten “12/05/24”, “Dec 5, 2024” y “5-Dec-24” en un único estándar. Los símbolos de moneda, los separadores de miles y los puntos decimales deben normalizarse antes de realizar cálculos numéricos. Los niveles de confianza de los modelos de IA señalan las extracciones de baja calidad que requieren revisión humana o un nuevo procesamiento. Los algoritmos de coincidencia de cadenas comparan los nombres de proveedores extraídos con listas maestras para corregir errores tipográficos y variantes.
La mala calidad de los datos de los sistemas IDP genera problemas que se agravan en todas las operaciones del negocio. Los importes de factura incorrectos provocan pagos erróneos, deterioran las relaciones con los proveedores y causan fallos en las auditorías. Los datos incorrectos afectan a la analítica posterior y hacen que los informes no sean fiables para la toma de decisiones. Una extracción limpia exige examinar con atención:
Los problemas de calidad de los datos cuestan dinero real a las empresas en correcciones manuales, errores de pago e incumplimientos normativos. Los ingenieros establecen controles de calidad en cada etapa del pipeline para detectar los problemas a tiempo y mantener la credibilidad de los sistemas automatizados.
Proteja su negocio de los errores de extracción
docAlpha combina la extracción inteligente con controles de calidad, comprobaciones de duplicados y validación basada en políticas para detener los datos incorrectos en su origen. Mejore la preparación para auditorías y reduzca las costosas correcciones manuales.
Reserve una demo ahora
La ingeniería de datos transforma los resultados caóticos de los documentos en estructuras consultables. La extracción de texto sin procesar de facturas o contratos genera datos desordenados que los analistas no pueden utilizar. Los ingenieros crean los pipelines que estandarizan formatos, validan campos y vinculan registros entre sistemas para que los modelos de ML y los paneles realmente funcionen.
La mayoría de las plataformas de procesamiento inteligente de documentos funcionan sobre data lakes. Esta arquitectura gestiona el contenido no estructurado mejor que los almacenes de datos. Los documentos llegan como PDF, imágenes y escaneos. Los data lakes almacenan estos archivos sin procesar sin obligar a encajarlos primero en tablas rígidas. Los equipos pueden extraer texto, entrenar modelos y crear pipelines en un solo lugar.
Convierta documentos sin procesar en datos útiles
docAlpha mantiene los documentos y los datos extraídos organizados, validados y localizables, para que la analítica y las operaciones no dependan de una limpieza posterior. Acelere la obtención de información sin sacrificar la calidad de los datos.
Reserve una demo ahora
Los sistemas IDP se conectan al almacenamiento en la nube mediante API nativas. Usted dirige la plataforma a su bucket de S3, su contenedor de Google Cloud Storage o su cuenta de Azure Blob. El sistema lee los documentos directamente desde estas ubicaciones. Los datos procesados se escriben de nuevo en el mismo almacenamiento o en otro destino que usted especifique. No se requieren transferencias de archivos ni middleware.
Los ingenieros de datos permiten a los analistas ejecutar consultas SQL complejas en enormes conjuntos de datos.
Sin una ingeniería sólida, los equipos de analítica pierden tiempo corrigiendo problemas de datos en lugar de encontrar respuestas.
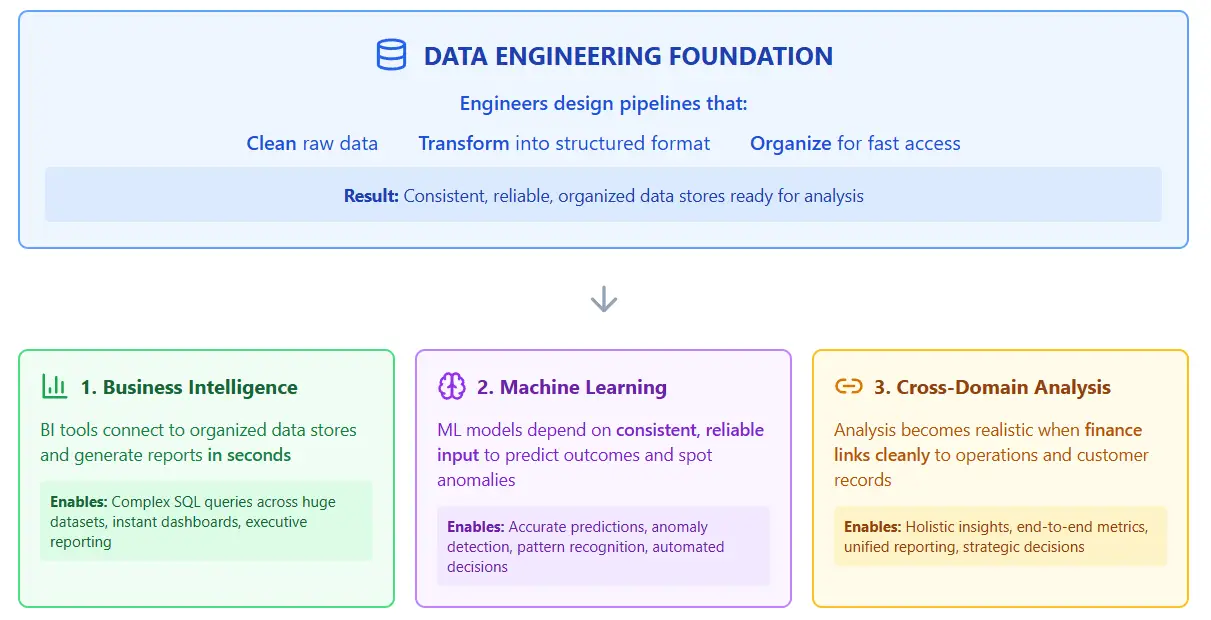
Cómo la ingeniería de datos sirve de base para la analítica avanzada
Cada caso demuestra cómo una ingeniería de datos adecuada crea la base para una implementación exitosa del IDP, resolviendo problemas de calidad, estandarización e integración de los datos que, de otro modo, limitarían la eficacia del procesamiento de documentos.
Una compañía de seguros implementó el IDP para extraer datos de 50,000 documentos de reclamaciones al mes. El sistema obtenía números de póliza, fechas y descripciones de daños con un 92% de precisión. Las extracciones sin procesar contenían formatos de fecha incoherentes, entradas duplicadas y campos desalineados. Los ingenieros de datos crearon pipelines de validación que estandarizaban los formatos y señalaban las anomalías. Así, los analistas de reclamaciones podían consultar el conjunto de datos limpio para detectar patrones de fraude y calcular tendencias de pago.
Lectura recomendada: ¿Qué es el procesamiento inteligente de documentos (IDP)?
Un bufete de abogados utilizó el IDP para procesar 10,000 contratos con proveedores en el marco de la revisión de una fusión. La plataforma extrajo de cada acuerdo las cláusulas, las fechas de renovación y las condiciones de responsabilidad. Los datos extraídos llegaron con variaciones ortográficas, valores faltantes y errores de formato procedentes de documentos escaneados. Los ingenieros crearon procesos de transformación que normalizaban los nombres de las empresas, completaban los vacíos con metadatos y vinculaban los contratos relacionados. El equipo buscó en la base de datos estructurada para identificar cláusulas de riesgo en minutos en lugar de semanas.
Una red hospitalaria implementó el IDP para digitalizar los expedientes en papel de tres clínicas adquiridas. El sistema escaneó y extrajo datos demográficos de los pacientes, diagnósticos y listas de medicamentos. Los datos de salida mezclaban abreviaturas, códigos obsoletos e información contradictoria entre fuentes. Los ingenieros de datos asignaron los códigos heredados a los estándares actuales, resolvieron los pacientes duplicados y crearon una base de datos unificada de historiales médicos. Así, los médicos pudieron acceder a historiales completos de los pacientes y a modelos de ML predictivos para identificar a los pacientes en riesgo que requieren intervención.
Un organismo regulador necesitaba extraer y analizar datos de millones de declaraciones empresariales y documentos de cumplimiento. Su solución de ingeniería de datos incluía una arquitectura de procesamiento distribuido, sistemas de gestión de metadatos y flujos de trabajo de control de calidad. Esta base permitió que su sistema IDP identificara y extrajera con precisión la información regulatoria clave en múltiples tipos de documentos, reduciendo los atrasos de procesamiento en un 87% y permitiendo al organismo concentrar sus recursos en la revisión del cumplimiento en lugar de en la captura manual de datos.
Flujos de trabajo de IDP que mueven las facturas automáticamente
InvoiceAction enruta, aprueba y contabiliza facturas con lógica de negocio automatizada. Acorte los tiempos de ciclo y mejore la previsibilidad del flujo de caja.
Reserve una demo ahora
El procesamiento de documentos está pasando de la simple captura de texto a la toma de decisiones autónoma. Los sistemas del futuro combinarán la inteligencia generativa con una ingeniería de datos escalable para gestionar la lógica de negocio en cada etapa.
Extracción multimodal: los modelos modernos ya leen texto e imágenes a la vez para comprender el diseño de los documentos. Los ingenieros deben crear pipelines que suministren a estos sistemas datos tanto visuales como semánticos.
Flujos de trabajo agénticos: los agentes de IA ya realizan tareas como aprobar reclamaciones o enrutar archivos sin ayuda humana. Los equipos de datos lo hacen posible creando conexiones seguras entre estos agentes y las bases de datos internas.
Comprensión generativa: los grandes modelos de lenguaje pueden resumir contratos complejos y responder preguntas sobre su contenido. Las capas de ingeniería garantizan que estos modelos dispongan de datos limpios y pertinentes para ofrecer respuestas precisas.
Procesamiento en vivo: las necesidades del negocio exigen que los documentos se procesen en el momento en que llegan al sistema. Los ingenieros utilizan herramientas basadas en eventos para mover los datos por el pipeline sin ningún tiempo de espera.
Pipelines con autocorrección: los sistemas ya utilizan machine learning para encontrar y corregir automáticamente los errores en los datos. La ingeniería de datos proporciona las herramientas de supervisión que rastrean estos cambios y validan la calidad de los datos.
Diseño centrado en la privacidad: las nuevas normativas exigen un control estricto del tratamiento de los datos personales en los documentos. Los ingenieros integran el enmascaramiento y el cifrado automatizados directamente en las capas de ingesta y almacenamiento.
Modelos especializados por sector: los modelos pequeños y adaptados están reemplazando a la IA general, incluso en el procesamiento legal o médico. Los equipos mantienen los datos de entrenamiento y los ciclos de retroalimentación necesarios para que estos modelos sigan siendo precisos.
Lectura recomendada: Automatización inteligente en la captura de datos: ¿humanos o máquinas?
El CxO fija el presupuesto para todas las herramientas y el personal de datos. Los líderes eligen entre el procesamiento sobre la marcha y el procesamiento por lotes para la empresa. Esta elección determina los sistemas en la nube de la pila de ingeniería. Un CTO define las normas de seguridad para todo el procesamiento de documentos. Los equipos de datos crean las capas de protección necesarias para cumplir estas normas. Las decisiones de la alta dirección marcan la velocidad del pipeline. Unos objetivos claros por parte de un líder ayudan a los ingenieros a crear solo las funciones más útiles.
 ¿Qué es el procesamiento inteligente de documentos (IDP)?
 Cómo la analítica de datos impulsa el éxito de la automatización de procesos
 7 beneficios de la automatización del procesamiento de documentos
 OCR: ¿qué es el reconocimiento óptico de caracteres?
 Validación de datos: clave para la precisión en el procesamiento de facturas
 El auge del machine learning en los negocios

