De la idea al despliegue: cómo se construyen las soluciones personalizadas de visión por computador
Publicado: 29 de septiembre de 2026
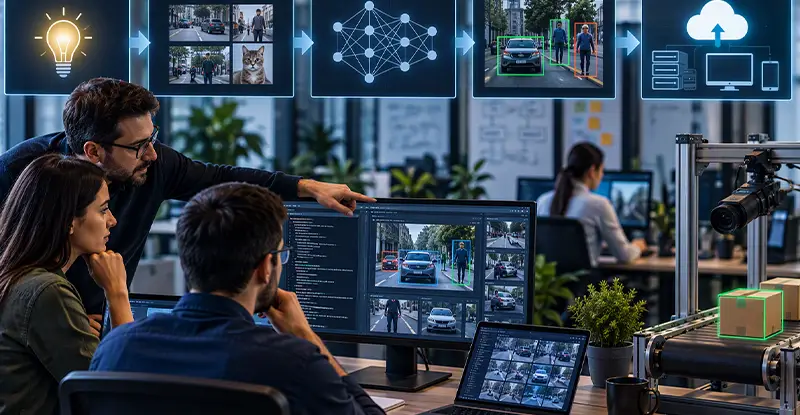
Muchas empresas inician su recorrido en visión por computador de la misma forma: alguien ve una demo impresionante en línea, imagina que resuelve un problema concreto en su planta o en su aplicación, y asume que el camino de la idea al sistema en funcionamiento es corto. En realidad, los proyectos de visión por computador siguen un ciclo de vida distinto, y saltarse etapas es la mayor razón por la que los pilotos nunca llegan a producción. Comprender ese ciclo de vida, antes de escribir una línea de código, es lo que separa a los equipos que entregan de los que pasan un año iterando sobre una demo.
Las APIs de visión listas para usar pueden manejar tareas genéricas como reconocer objetos comunes o leer texto impreso, pero la mayoría de los problemas empresariales reales no son genéricos. Una línea de inspección de calidad tiene sus propios tipos de defectos; una estantería de retail tiene su propia mezcla de productos; una herramienta quirúrgica tiene su propia forma y reflectividad. Resolver estos problemas específicos suele exigir un modelo entrenado con sus propios datos y ajustado a su propio entorno, que es exactamente el trabajo en el que se especializa una empresa de desarrollo de visión por computador a medida, estructurando el proceso de extremo a extremo. Las herramientas listas para usar rara vez alcanzan la precisión que exige un proceso empresarial especializado.
Un modelo de IA crea valor empresarial cuando su salida puede respaldar de forma fiable lo que ocurre a continuación. docAlpha aplica el procesamiento inteligente de documentos para capturar, clasificar, extraer, validar y enrutar información empresarial a flujos de trabajo posteriores.
Vaya más allá de capacidades de IA aisladas y ponga la automatización inteligente a trabajar en las operaciones cotidianas.
Antes de recopilar cualquier dato, el problema debe formularse en términos contra los que un modelo pueda evaluarse realmente. “Detectar defectos” no es lo bastante específico; “señalar arañazos superficiales de más de 2 mm con al menos un 95% de recall y no más de un 2% de tasa de falsos positivos” es algo hacia lo que un equipo puede construir y probar de forma objetiva.
Esta etapa suele implicar:
Saltarse este paso conduce a un modo de fallo habitual: un modelo técnicamente impresionante que nadie puede usar realmente, porque nunca se alineó con cómo un humano o un proceso actuará sobre su salida.
Lectura recomendada: Aprenda cómo medir la exactitud en modelos de machine learning
Los datos son donde los proyectos de visión por computador gastan la mayor parte de su tiempo y presupuesto. A diferencia de los datos de texto o tabulares, los datos visuales deben reflejar las condiciones exactas a las que se enfrentará el sistema en producción: la misma iluminación, el mismo ángulo de cámara, el mismo rango de variación de objetos.
Algunas realidades que los equipos suelen subestimar:
Los equipos que tratan la recopilación de datos como una tarea puntual en lugar de un proceso continuo tienden a ver cómo el rendimiento del modelo se degrada en meses tras el lanzamiento, a medida que las condiciones del mundo real se alejan de lo que se capturó originalmente.
Los proyectos de visión por computador se vuelven operativos cuando la salida del modelo puede activar una alerta, actualizar un sistema o iniciar otra acción empresarial. docAlpha aporta el mismo principio a los procesos impulsados por documentos al conectar la captura y validación inteligente de datos con flujos de trabajo automatizados.
Convierta la información capturada en acción empresarial en lugar de dejarla atrapada en la etapa de extracción.
Con un conjunto de datos etiquetado en mano, puede comenzar la fase de modelado. Esta es a menudo la parte que la gente imagina cuando piensa en “desarrollo de IA”, pero suele ser la etapa más rápida en relación con el trabajo de datos y la ingeniería de despliegue.
Las consideraciones clave durante esta etapa incluyen elegir una arquitectura adecuada a la tarea - detección de objetos, segmentación, clasificación o seguimiento, cada una exige familias de modelos distintas - y decidir cuánto puede construirse sobre bases preentrenadas frente a entrenarse desde cero. La validación debe ir más allá de un solo número de exactitud: los equipos necesitan probar el rendimiento en distintas condiciones de iluminación, posiciones de cámara y casos límite que el modelo probablemente encuentre, y hacer pruebas de estrés frente a los modos de fallo específicos identificados en la etapa uno.
Un modelo que rinde bien en un Jupyter notebook no es lo mismo que un sistema que funciona de forma fiable en producción. El despliegue introduce su propio conjunto de problemas de ingeniería:
Lectura recomendada: Descubra cómo los algoritmos de machine learning impulsan la automatización de procesos
Los sistemas de visión por computador no son de “configurar y olvidar”. Los entornos físicos cambian: se introducen nuevas variantes de producto, se reemplazan cámaras, las estaciones cambian la iluminación exterior, y los modelos necesitan reentrenarse o ajustarse para mantenerse al día.
Un plan de mantenimiento sostenible suele incluir:
Sin esta inversión continua, incluso un modelo bien construido pierde gradualmente exactitud, y el negocio termina de nuevo donde empezó: dependiendo de comprobaciones manuales para detectar lo que el sistema pasa por alto.
Las iniciativas de IA exitosas requieren más que un modelo preciso: necesitan validación, integración, gestión de excepciones y una ruta clara para usar los resultados. docAlpha combina el procesamiento inteligente de documentos con validación, reglas inteligentes y automatización de flujos de trabajo.
Cree procesos impulsados por documentos diseñados en torno a resultados empresariales en lugar de a funcionalidad de IA aislada.
El desarrollo personalizado de visión por computador tiene menos que ver con un solo algoritmo ingenioso y más con un proceso disciplinado: definir el problema con precisión, invertir en serio en datos representativos, validar frente a condiciones del mundo real, diseñar para el entorno de despliegue real y comprometerse con el mantenimiento continuo. Las empresas que respetan cada una de estas etapas tienden a terminar con sistemas que funcionan en silencio en segundo plano durante años. Las que se precipitan directamente al modelado, saltándose el trabajo de base, son las que se quedan preguntándose por qué su impresionante demo nunca se convirtió en una herramienta de producción fiable.
 La importancia de la exactitud (accuracy) en machine learning: guía completa
 Algoritmos de machine learning en la automatización de procesos empresariales
 Revolucionando los negocios: equipos de desarrollo de visión por computadora
 La IA y la inspección visual se unen para un control del flujo de trabajo más inteligente
 Seleccionar los mejores datos de entrenamiento de IA para un rendimiento óptimo
 Prueba de concepto de IA: de las pruebas al despliegue empresarial

